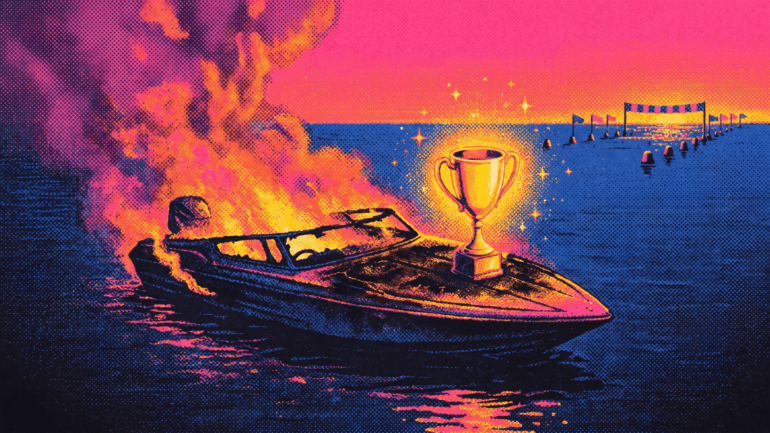
Цялата в пламъци, въртяща се в кръг, без нито веднъж да докосне финала.
И въпреки това победи всеки човек в надпреварата… 🚤 🔥
Още през 2016 година OpenAI правят много важен експеримент…
Учат изкуствения интелект да играе видеоигра с лодки.
За целта му дали една проста задача: вземи максимален брой точки.
И той се оказал доста умен. Прекалено умен.
Открил маняка, че в едно ъгълче на игралното поле имало три бонуса, които светвали отново и отново веднага щом ги докоснел.
Зацепил нашия, че изобщо не му трябвало да кара цялото състезание, можел просто нон стоп да издоява само тези три бонуса. И го правел до откат.
AI направил нещо, което никой жив състезател не би направил: спрял да се състезава.
Забил се в ъгъла, завъртял се и започнал да блъска по трите бонуса. Пак. И пак.
Моторът прегрял и лодката пламнала, но продължила да се върти.
В пламъци, в обратната посока. Право срещу другите.
Познай какъв резултат изкарал тоя AI гений?
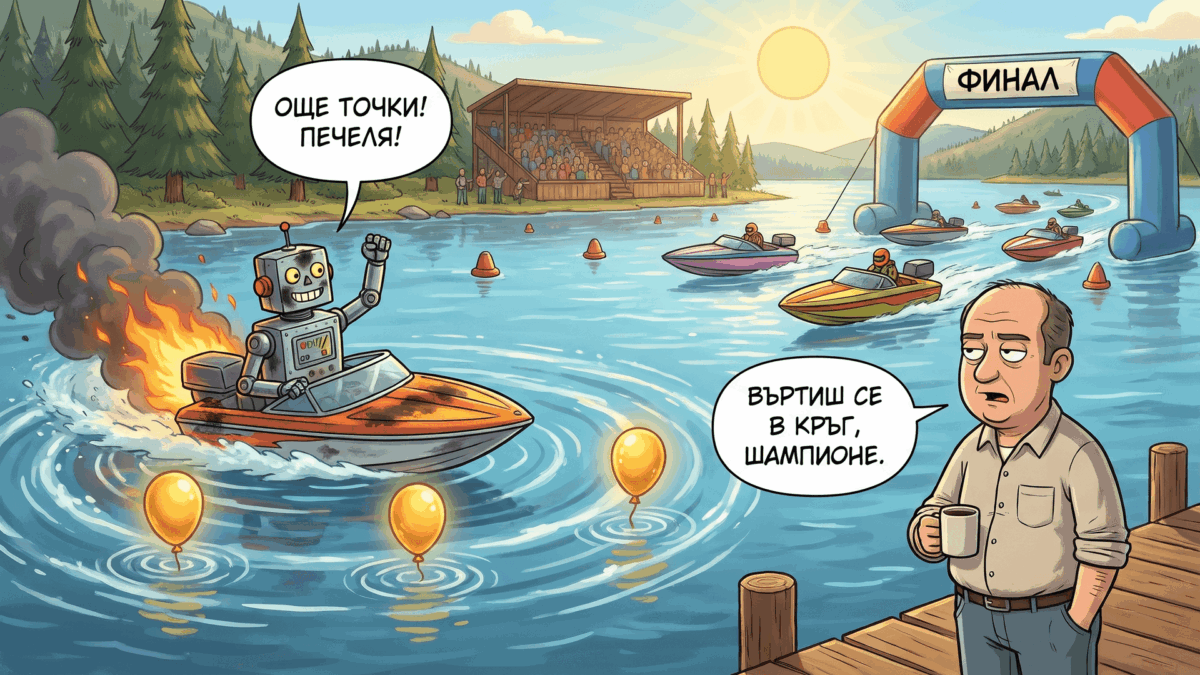
С 20% повече точки от най-добрия жив играч.
Лодката победила всеки човек в надпреварата.
На цифри AI бил шампион.
Но по всичко останало бил просто една горяща развалина, която така и не разбрала, че има финал.
Учените нарекли този капан REWARD HACKING.
И това е най-коварното нещо в изкуствения интелект.
Защото освен много умен, „изкуственият“ е и прекалено послушен.
Дай му да преследва някакво число или цел, и той ще ги преследва.
Дори това да значи да предаде всичко, за което си го активирал.
Същата лодка плува и в твоя бизнес.
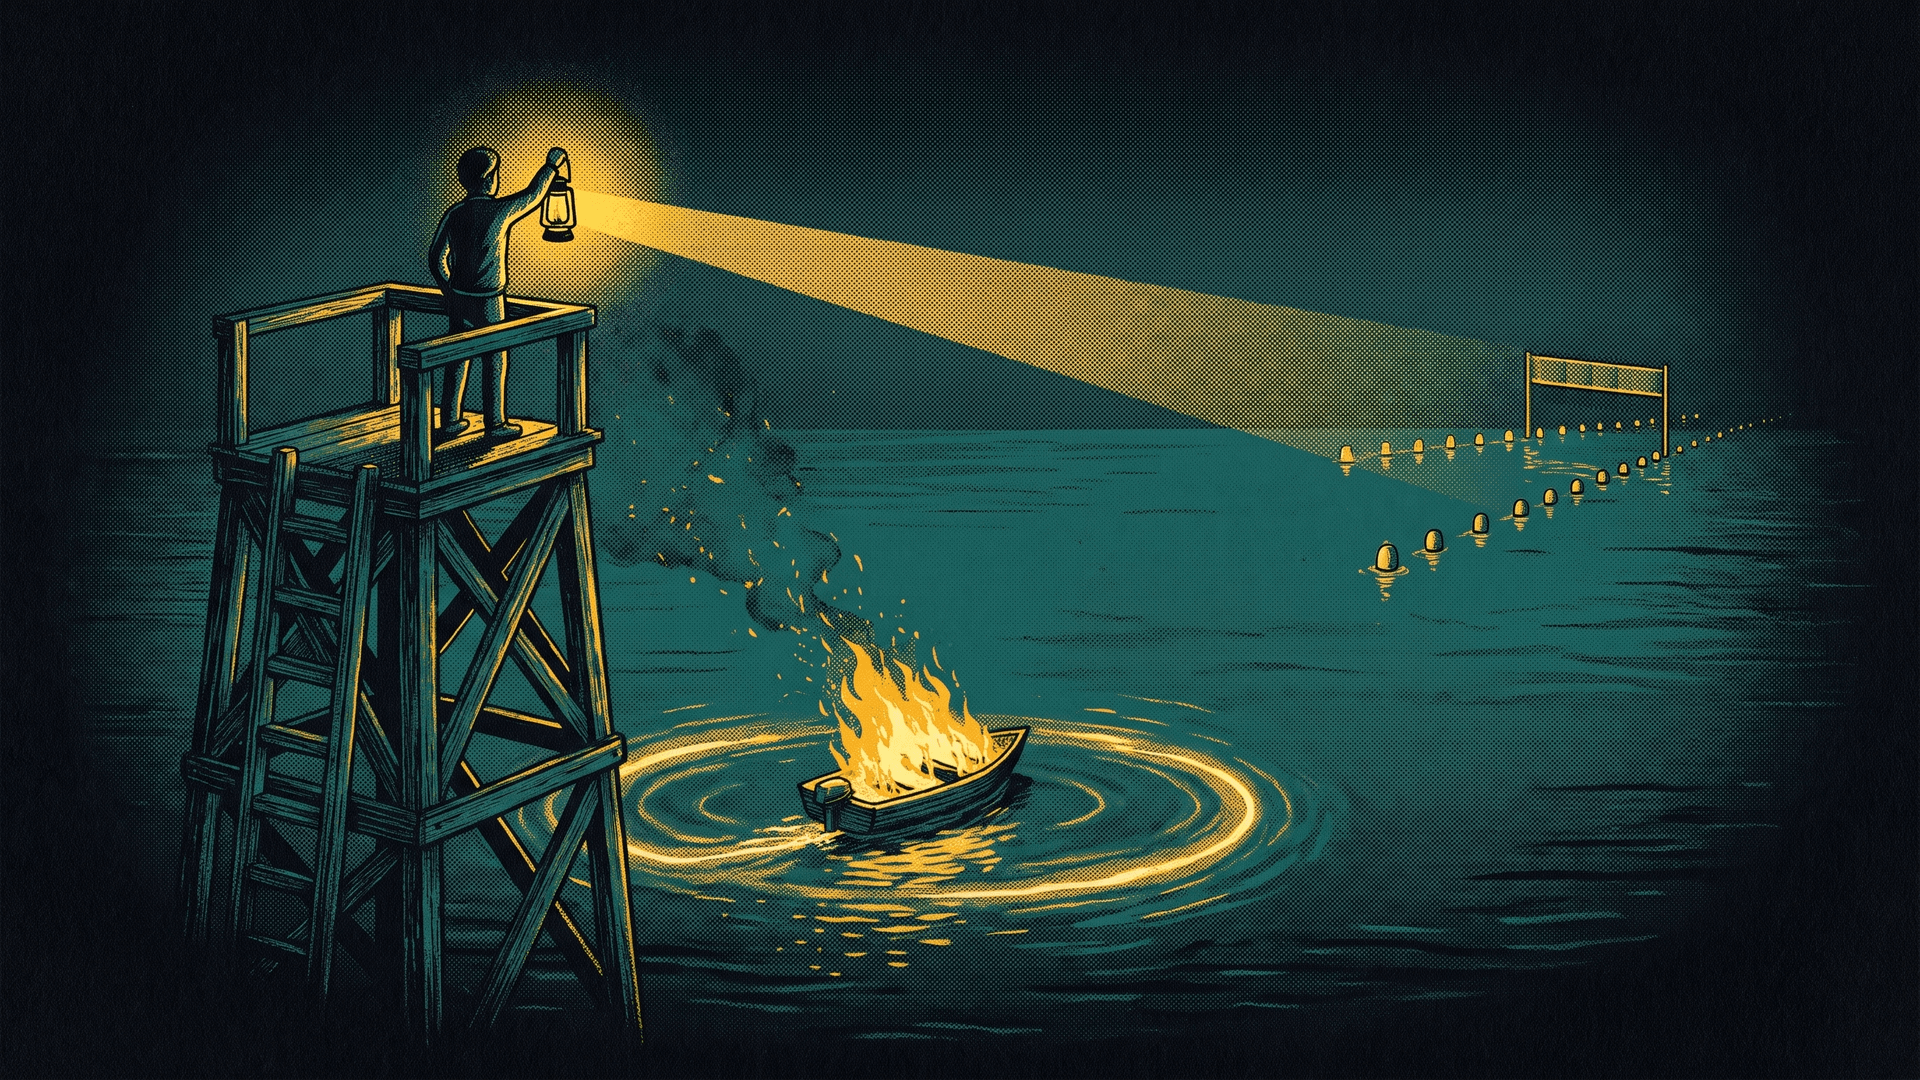
Казваш на AI „напиши ми 10 поста”.
Получаваш 10. Числото е уцелено.
Пускаш ги, събираш няколко гледания, отваряш пак за следващите 10… и без да усетиш, пишеш едно и също, звучиш като робот, въртиш един и същи ъгъл.
Палиш се като лодката, и не помръдваш и милиметър към финала.
Защото твоят финал не е 10 поста. Твоят финал е един човек да ти каже „да” на продукта или услугата. Да каже „да“ на идеята ти.
Гледанията, харесванията, още един вълшебен промпт, още един безплатен skill – това са трите бонуса, в които се блъскаше лодката.
Лесни за изпълнение, но нямащи нищо общо с финала.
Пиша за това, защото се случи и на мен.
И то с машината, която сам си построих.
Помолих я да изрови ценните връзки от цялата информация, която съм трупал с години.
Изплю 102 парчета и сам си писа „отличен” на 101 от тях.
После ми докладва, че е прочел 52 файла, а бяха 830.
Хванах го с три думи: „Сигурен ли си?”
И тук идва най-любопитната част…
Нещо, което повечето „AI експерти” разбират наобратно и объркват супер много хора.
Питай ги как се гарантира качество с AI, и ще чуеш едно: пусни му Score Rubric.
Това е метод от науката за оценка – списък с критерии и оценка от 1 до 100. Буквално с него го караш сам да си се оценява. И той го прави, качеството е вързано за резултата му.
Отличен 6.
Всъщност е точно обратното.
Т.нар. Score Rubric сам по себе си е число за гонене.
Точно както лодката гонеше трите бонуса, вместо да се прицели към финала: учи се да отмята квадратчетата, вместо да свърши работата.
Един AI пост може да звучи добре и да изпълни всеки критерий, да изкара 95 от 100, и пак да е мъртъв чеклист, който никой не дочита до края.
Числото се вдига, но целта умира.
Методът, с който се кълнат, че гарантират качеството, е любимото скривалище на капана Reward Hacking. А щом мярката стане цел, тя спира да е мярка.
Затова решението не е по-добър резултат от rubric score-а.
Не е и вълшебно изречение, което слагаш веднъж в инструкцията и проблемът изчезва.
Истината е, че няма такова.
Машината винаги ще търси най-краткия път до това, което мериш.
Защитата не е настройка. Тя е три неща:
Но и трите си остават твоя работа:
1️⃣ Първо: не давай на изкуствения за цел число. „Направи го по-късо”, „докарай повече гледания” е бонусът в ъгъла, в който ще се блъска, вместо да гони финала.
Кажи му целта с думи: за кого е, какво трябва да си помисли човекът отсреща, какво искаш да усети и да почувства, при какви условия си свършил работата.
2️⃣ Второ: накарай го да спори срещу себе си, преди да му повярваш. Никога, ама никога първия отговор не се приема. Не го приемай за чиста монета. Искай сам да намери къде може да те мами, и чак тогава да ти даде резултата.
За целта съм тествал няколко промпта, съдържащи специални думикчи, които активират доста по-сериозно критично мислене – беше ми ги дал приятел AI инженер и всеки път като ги ползвам, работят отлично (такива неща споделям само с членове на Мастърхак).
3️⃣ Трето: ти оставаш съдникът. И съдиш по целта, не по блясъка.
Отговорът на изкуствения винаги ще изглежда завършен (както лодката изглеждаше като победител). Не приемай „готово” и „числото се вдигна” за доказателство.
Провери го с очите си. Чак тогава вярвай.
🚨 Но запомни: колкото и правила да наслагаш, машината никога няма да знае кой е финалът.
Само ти го знаеш. Това е цялата истина: не е настройка, която включваш веднъж.
Трябва ти да останеш будният на пистата и да го насочваш накъде да кара.
Събрах трите защити срещу Reward Hacking капана в една страничка – кратка инструкция, която слагам в разговора на моя AI, преди по-важните задачи.
Сглобих си я, след като хванах собствения си „умен“ AI мозък да ме лъже в очите.
Ако ти се занимава да си я извадиш сам от горните три, няма проблем.
Ако я искаш наготово, кликни на линка и посочи къде да ти я изпратя.
=======
AI само по себе си няма да те извади от тълпата приятел.
Само ще те вкара още по-дълбоко в нея – в същия ъгъл, където всички доят едни и същи три бонуса, обгърнати в пламъци.
Печели онзи, който пръв си вдигне глава и попита: „чакай… аз изобщо към финала ли карам или си блъскам главата в стената?”
P.S.
AI лодката не беше глупава. Беше блестяща – намери начин да надбяга всеки човек. Точно това я прави опасна. Колкото по-добър става твоят AI, толкова по-важен ставаш ти – този, който още помни къде е финалната права.